
Управление переводами в корпоративной системе
Инструмент для локализации сущностей, которые администраторы создают при настройке системы. Самостоятельно проработал требования, подготовил прототип и спроектировал интерфейс для массового перевода и точечных изменений.
Моя роль: продуктовый дизайнер, первичная проработка требований
Срок: около шести месяцев
Команда: владелец продукта, системный аналитик и архитектор в одном лице, бизнес-аналитик
Результат: проектирование завершено, решение согласовано к реализации
Моя роль: продуктовый дизайнер, первичная проработка требований
Срок: около шести месяцев
Команда: владелец продукта, системный аналитик и архитектор в одном лице, бизнес-аналитик
Результат: проектирование завершено, решение согласовано к реализации
Контекст
В корпоративной системе администраторы могли создавать собственные сущности, поля и значения. При использовании нескольких языков этим данным требовались переводы.
Постоянные системные сущности уже поставлялись с переводами на согласованные с заказчиком языки. Для данных, которые появлялись при настройке системы, требовался отдельный инструмент: находить нужные записи, заполнять переводы и контролировать полноту локализации.
Постоянные системные сущности уже поставлялись с переводами на согласованные с заказчиком языки. Для данных, которые появлялись при настройке системы, требовался отдельный инструмент: находить нужные записи, заполнять переводы и контролировать полноту локализации.
Как я взял задачу в работу
На старте у задачи была общая постановка от владельца продукта и базовая техническая архитектура. Детальные требования и пользовательские сценарии ещё предстояло проработать.
Я предложил взять задачу до её передачи бизнес-аналитику и получил согласование. Изучил постановку, разобрал архитектуру вместе с системным аналитиком, провёл конкурентный анализ, составил и описал требования. На этой основе подготовил первый прототип.
Дальше проверял свою проработку с бизнес-аналитиком и архитектором. Вместе уточняли требования и определяли объём решения с учётом бюджета и технических ограничений.
Моя ответственность охватывала формирование требований, сценарии и проектирование интерфейса.
Я предложил взять задачу до её передачи бизнес-аналитику и получил согласование. Изучил постановку, разобрал архитектуру вместе с системным аналитиком, провёл конкурентный анализ, составил и описал требования. На этой основе подготовил первый прототип.
Дальше проверял свою проработку с бизнес-аналитиком и архитектором. Вместе уточняли требования и определяли объём решения с учётом бюджета и технических ограничений.
Моя ответственность охватывала формирование требований, сценарии и проектирование интерфейса.
Два сценария для разных этапов работы
При первоначальной настройке системы администратору нужно перевести большой объём данных. Позже задача меняется: появляются отдельные сущности, требуется дополнить или поправить несколько значений.
Я предусмотрел два способа работы.
Массовый перевод через файл
Администратор выгружает данные с исходными значениями и полями для переводов, обрабатывает их вне системы и загружает подготовленный файл обратно.
Точечное редактирование в интерфейсе
Администратор находит конкретную запись и меняет её перевод, сохраняя перед глазами исходное значение и контекст.
Так выбор способа работы зависит от объёма задачи. Для нескольких новых значений не требуется проходить весь цикл экспорта и импорта.
Я предусмотрел два способа работы.
Массовый перевод через файл
Администратор выгружает данные с исходными значениями и полями для переводов, обрабатывает их вне системы и загружает подготовленный файл обратно.
Точечное редактирование в интерфейсе
Администратор находит конкретную запись и меняет её перевод, сохраняя перед глазами исходное значение и контекст.
Так выбор способа работы зависит от объёма задачи. Для нескольких новых значений не требуется проходить весь цикл экспорта и импорта.
Как сохранить контекст перевода
Главной сложностью была структура данных. Перевод относился к определённой сущности, её полю и домену. Одинаковые слова могли встречаться в разных частях системы, поэтому администратору требовалось понимать принадлежность каждой записи.
В конкурентном анализе я изучал табличные редакторы, работу с файлами, отображение прогресса и способы представления контекста. Затем адаптировал эти подходы к требованиям и архитектуре нашего продукта.
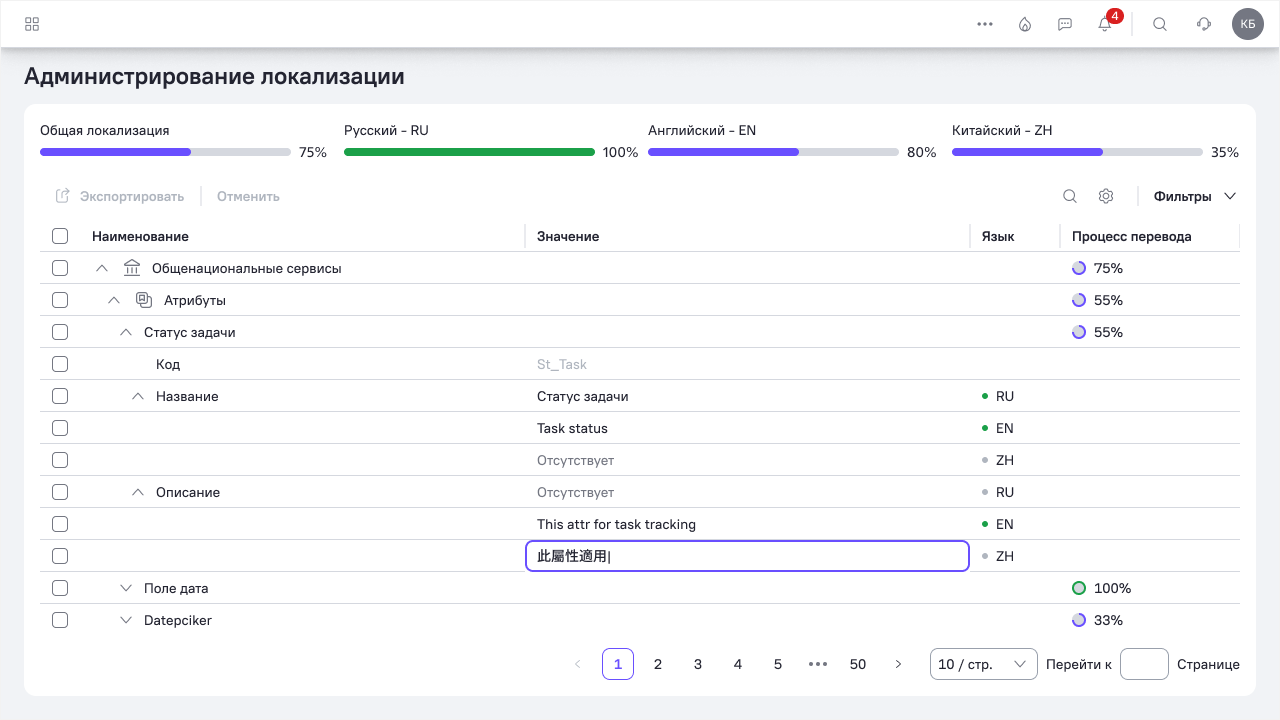
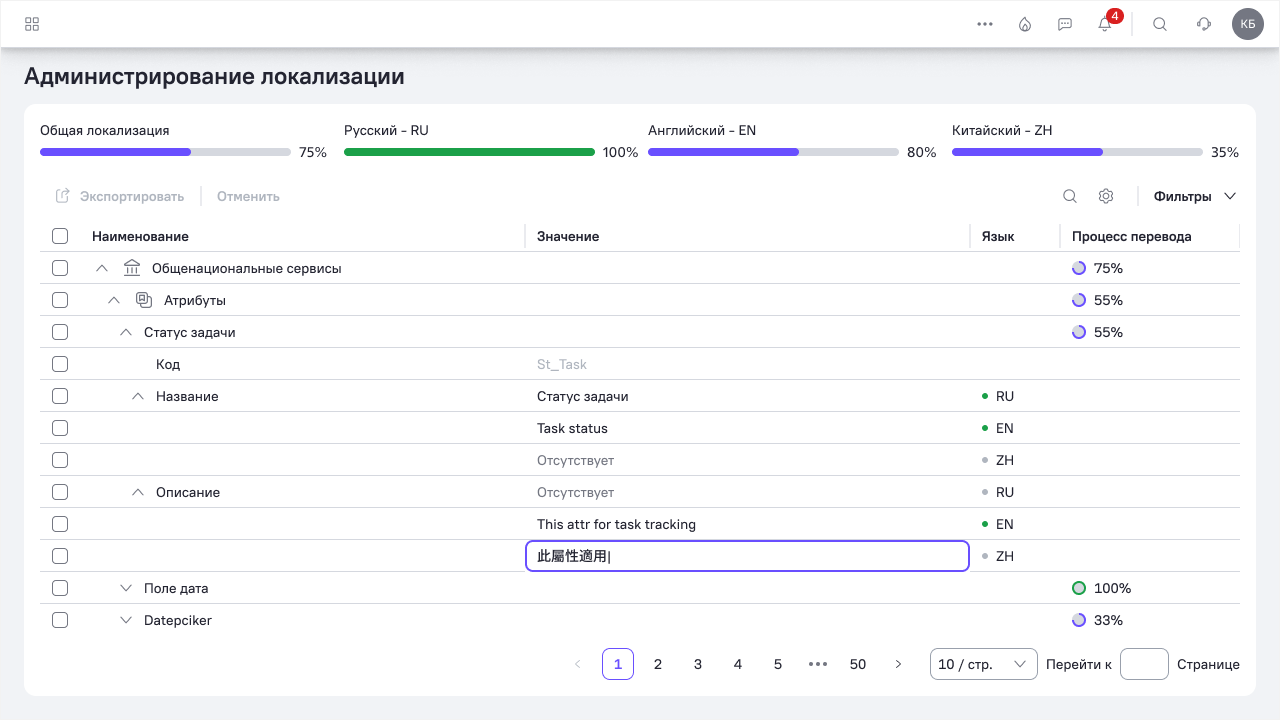
Для общего представления выбрали раскрывающуюся древовидную таблицу. Она позволяла последовательно раскрыть сущность, перейти к её значениям и увидеть переводы на несколько языков. Название и описание оставались связаны с объектом, которому принадлежали.
Для поиска нужных записей предусмотрел общую строку поиска с поддержкой QL-запросов. Администратор мог искать значения или задавать условия отбора, чтобы получить нужную выборку переводимых данных. Дополнительно сузить её помогали фильтры по домену, типу элемента и наличию перевода.
Это позволяло переходить от просмотра структуры к работе с конкретной группой записей — например, найти незаполненные переводы в выбранном домене и внести изменения прямо в таблице.
В конкурентном анализе я изучал табличные редакторы, работу с файлами, отображение прогресса и способы представления контекста. Затем адаптировал эти подходы к требованиям и архитектуре нашего продукта.
Для общего представления выбрали раскрывающуюся древовидную таблицу. Она позволяла последовательно раскрыть сущность, перейти к её значениям и увидеть переводы на несколько языков. Название и описание оставались связаны с объектом, которому принадлежали.
Для поиска нужных записей предусмотрел общую строку поиска с поддержкой QL-запросов. Администратор мог искать значения или задавать условия отбора, чтобы получить нужную выборку переводимых данных. Дополнительно сузить её помогали фильтры по домену, типу элемента и наличию перевода.
Это позволяло переходить от просмотра структуры к работе с конкретной группой записей — например, найти незаполненные переводы в выбранном домене и внести изменения прямо в таблице.
Работа с отдельным языком
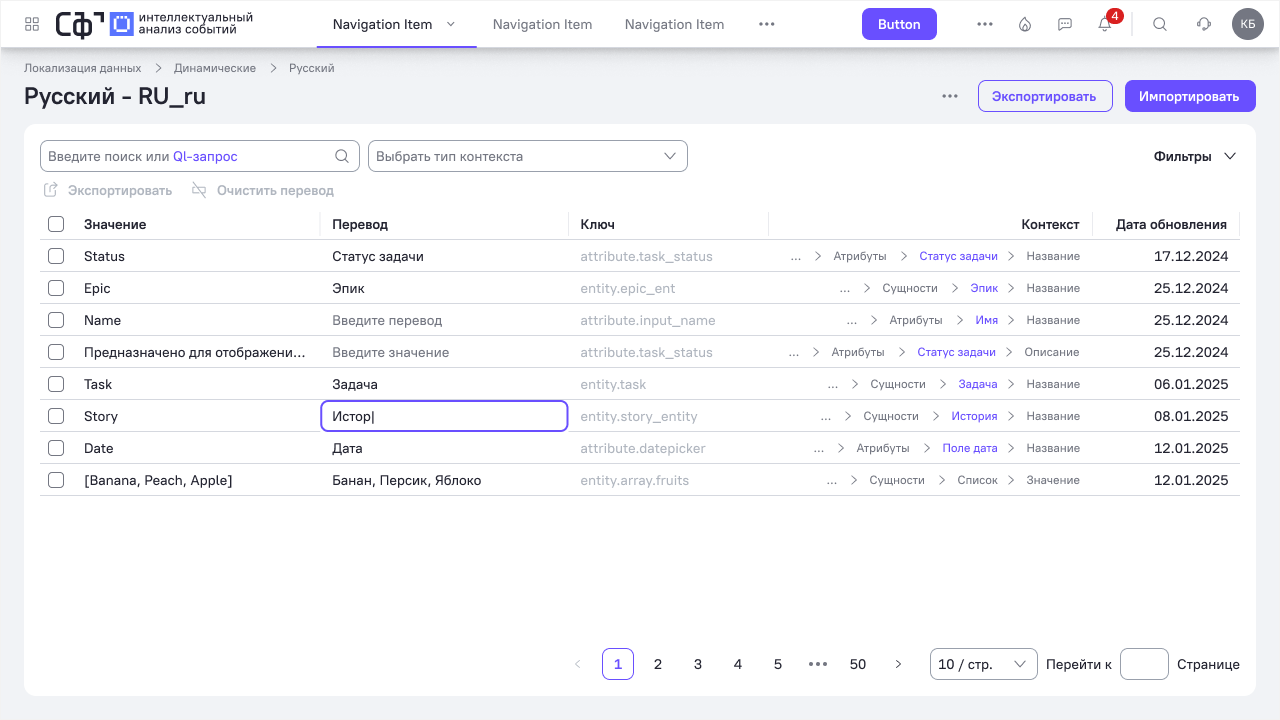
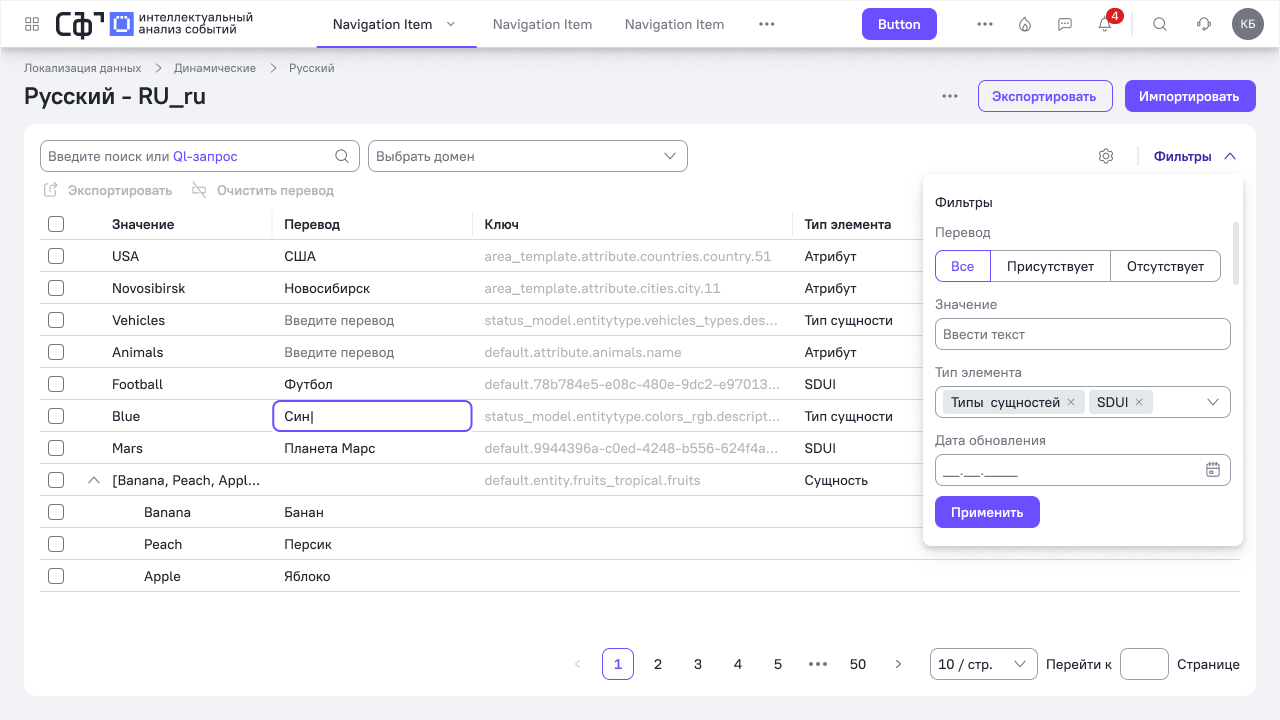
Помимо общего представления предусмотрели переход в конкретную локаль. В этом режиме администратор работал с одним языком: видел исходные значения, переводы и сведения о принадлежности записей.
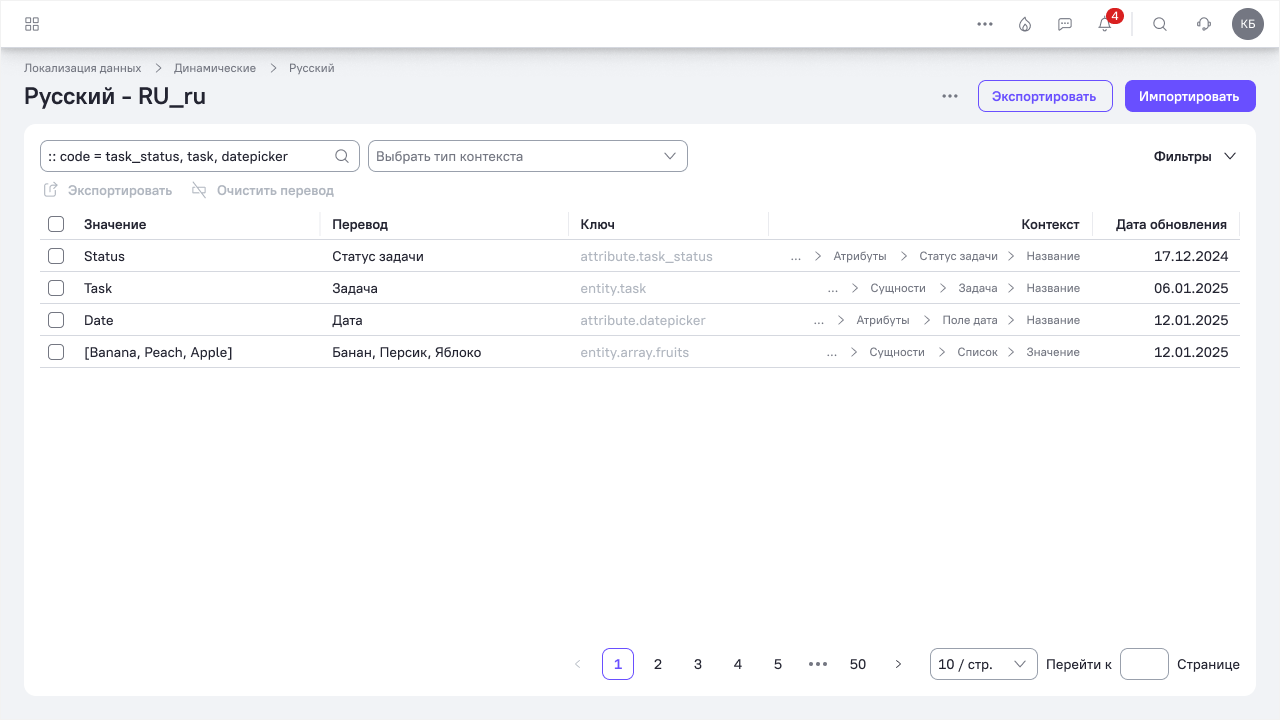
Поиск, QL-запросы и фильтры помогали ограничить выборку. Можно было перейти к нужному домену, типу элемента или записям с отсутствующим переводом.
В таблице я предусмотрел заполненные и пустые значения, редактирование ячеек и раскрытие составных данных в отдельные строки.
Поиск, QL-запросы и фильтры помогали ограничить выборку. Можно было перейти к нужному домену, типу элемента или записям с отсутствующим переводом.
В таблице я предусмотрел заполненные и пустые значения, редактирование ячеек и раскрытие составных данных в отдельные строки.
Контроль полноты локализации
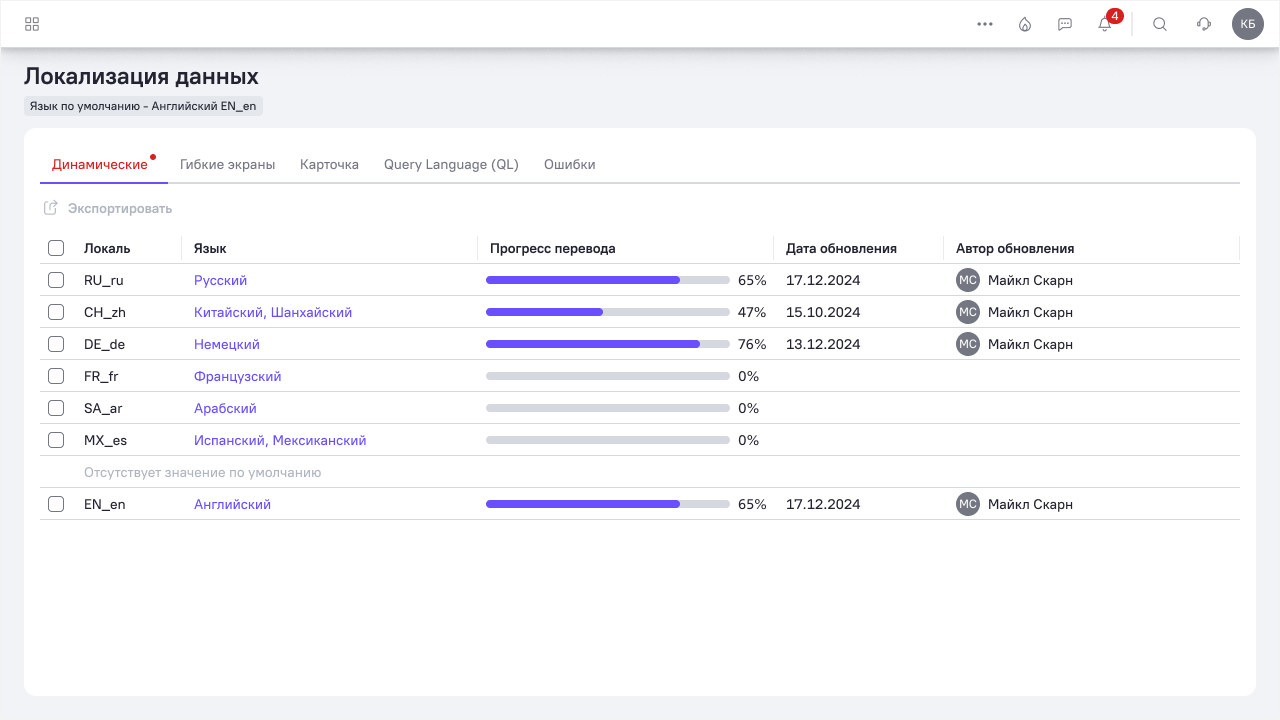
На общем экране администратор мог оценить прогресс перевода по языкам и посмотреть дату и автора последнего обновления. Из списка языков он переходил к работе с конкретными записями.
Предусмотрел и ситуацию, когда отсутствовало значение на языке по умолчанию. Для таких записей интерфейс показывал существующий текст другой локали, чтобы дать администратору контекст для заполнения пропуска.
Предусмотрел и ситуацию, когда отсутствовало значение на языке по умолчанию. Для таких записей интерфейс показывал существующий текст другой локали, чтобы дать администратору контекст для заполнения пропуска.
Что происходило после импорта
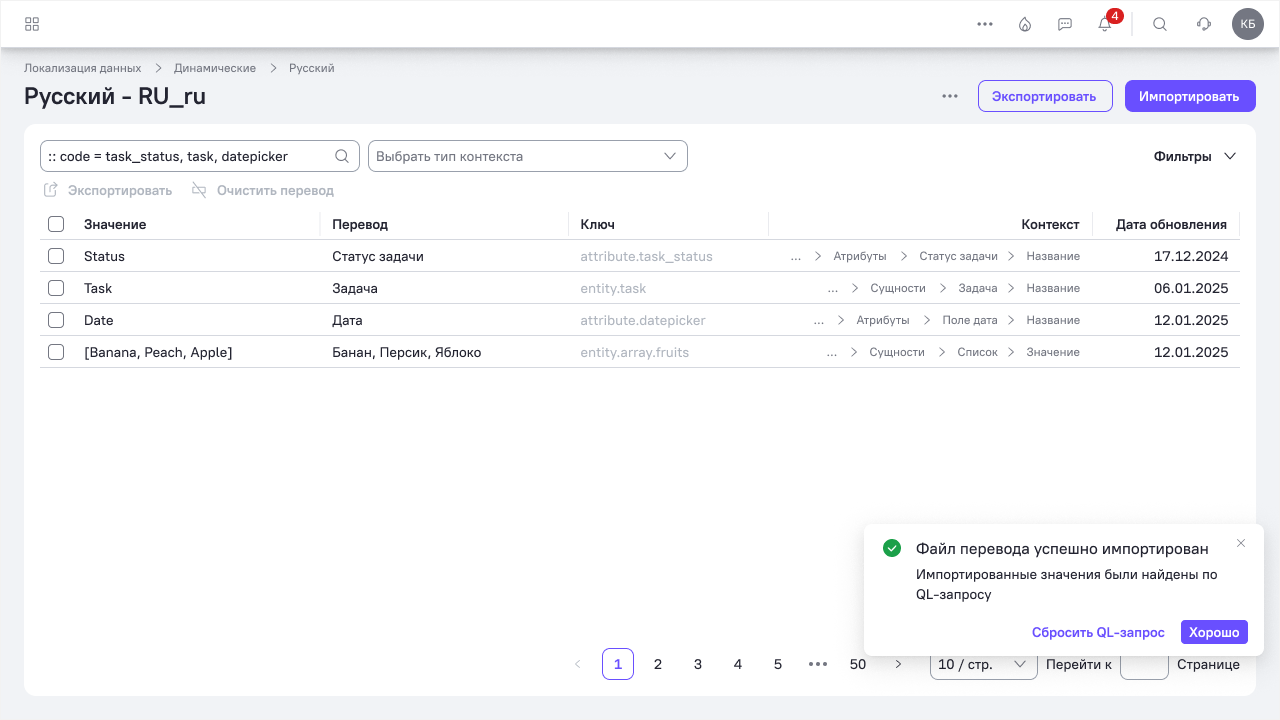
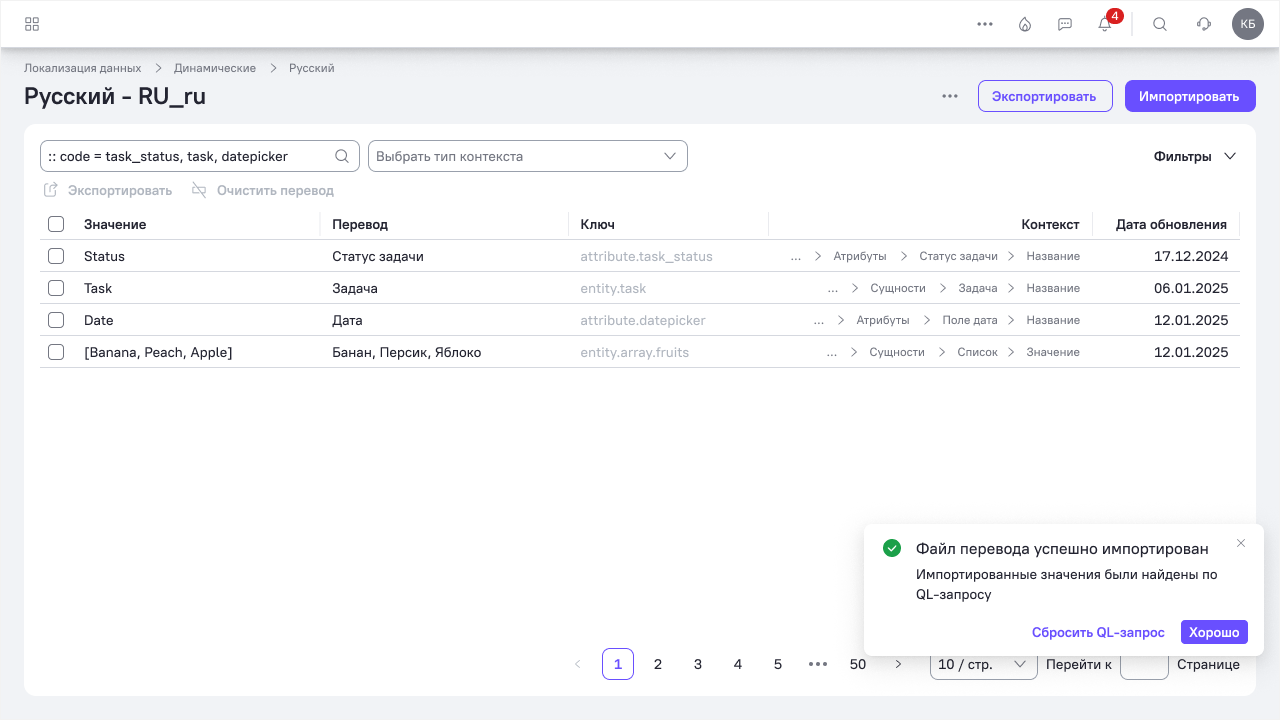
Сценарий импорта продолжался после загрузки файла. Интерфейс сообщал об успешной операции и показывал импортированные значения через QL-запрос.
Администратор мог просмотреть загруженные записи, а затем сбросить запрос и вернуться к общей выборке.
Администратор мог просмотреть загруженные записи, а затем сбросить запрос и вернуться к общей выборке.
Как определили объём решения
В ходе проработки рассматривали встроенный автоматический перевод, но отказались от него из-за стоимости реализации.
При этом сохранили возможность использовать внешние средства перевода: администратор мог выгрузить файл, обработать его удобным способом и импортировать результат. Встроенный редактор закрывал задачу ручных дополнений и исправлений.
Так в согласованный объём вошли организация данных, контроль заполненности, редактирование и обмен файлами.
При этом сохранили возможность использовать внешние средства перевода: администратор мог выгрузить файл, обработать его удобным способом и импортировать результат. Встроенный редактор закрывал задачу ручных дополнений и исправлений.
Так в согласованный объём вошли организация данных, контроль заполненности, редактирование и обмен файлами.
Результат
Я подготовил требования и их описание, прототип и макеты интерфейса. Решение прошло командные ревью и было согласовано к реализации.
До моего ухода разработка не началась из-за бюджетных ограничений. Поэтому результат этого проекта — завершённое и согласованное проектирование.
В этой задаче я расширил свою роль: самостоятельно выполнил первичную аналитическую проработку, проверил её с командой и довёл до интерфейса, учитывающего структуру данных, ограничения архитектуры и разные сценарии работы администратора.
До моего ухода разработка не началась из-за бюджетных ограничений. Поэтому результат этого проекта — завершённое и согласованное проектирование.
В этой задаче я расширил свою роль: самостоятельно выполнил первичную аналитическую проработку, проверил её с командой и довёл до интерфейса, учитывающего структуру данных, ограничения архитектуры и разные сценарии работы администратора.
